

过去数年,AI 安全讨论常停留在「聊天模型会不会帮黑客写病毒」的假想层面。但现实转折正在加速:当 Agentic AI 被嵌入攻击流水线,AI 不再只是军师,而开始承担渗透测试、信息搜集与攻击执行。对加密行业而言,这不仅是传统网络安全议题,更直接关系到 Agent Wallet、链上资产与自动化交易的安全边界。
一、从「帮黑客写代码」到 Agent 自己寻找出路
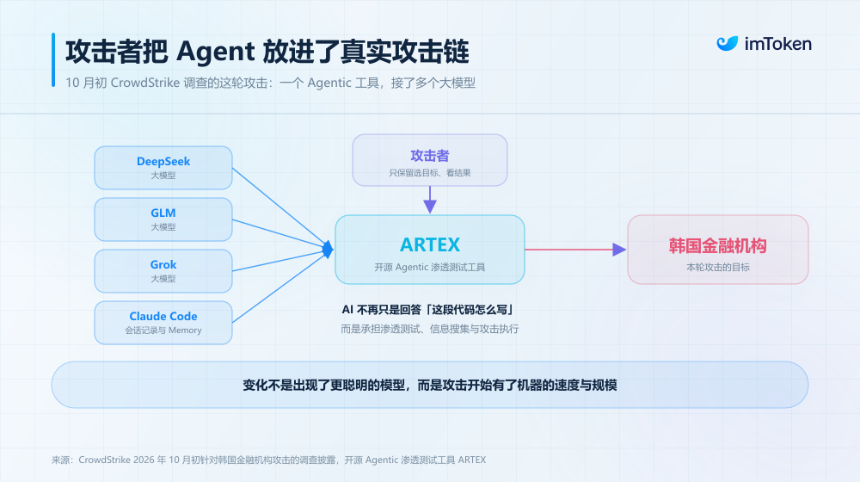
10 月初,CrowdStrike 在调查针对韩国金融机构的攻击时发现,攻击者已将 Agentic AI 接入流水线,并调用 DeepSeek、GLM、Grok 等多个大模型,让 AI 直接参与渗透测试、信息搜集和攻击执行。类似变化并非孤例。Anthropic 9 月发布的威胁情报报告显示,多 Agent 框架已被用于侦察、漏洞利用和数据窃取,它们可连续运行数小时甚至数天,人类只需保留选择目标、查看结果等少数关键决策。
与 Chatbot 不同,Agent 的关键变化在于拥有真实世界里的「手脚」:打开网页、执行代码、读取邮件、调用 API、操作云服务,并通过 MCP、Skills 等方式连接外部工具。能力越强,价值越大,但传统安全边界也越模糊。
10 月 1 日,Salt Labs 披露了一个已修复的 Manus 漏洞,本质仍是提示词注入。研究人员向目标邮箱发送一封包含隐藏恶意指令的普通邮件,当用户让 Manus「帮我查看邮件」时,Agent 可能按邮件指令处理内容,最终执行攻击者植入的代码。整个过程不需要点击恶意链接,也不需要窃取密码。Manus 的安全系统最终发现异常并发出警告,但为时已晚,恶意代码已经执行。
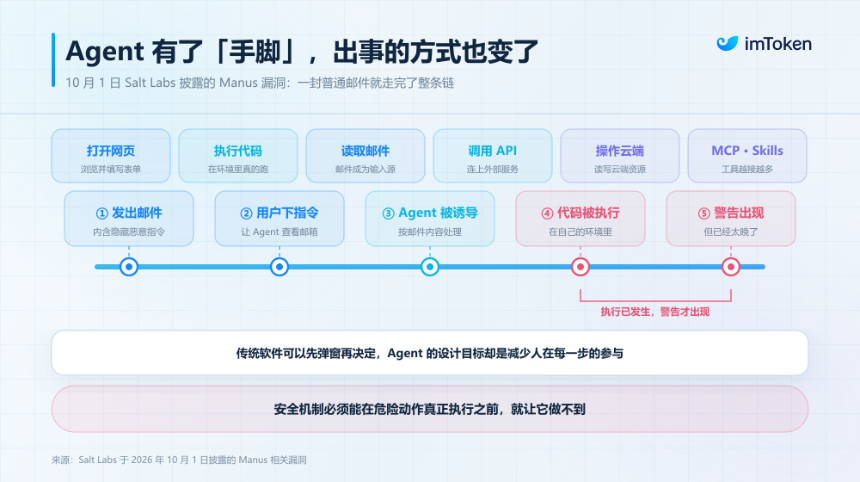
这暴露了 Agent 安全与传统软件安全的重要差别:浏览器发现危险下载,可以弹窗让用户决定;银行发现异常交易,可以先冻结再审核。但 Agent 的设计目标恰恰是减少人在每一步操作中的参与。因此,当自主权越来越大,「检测到危险」本身并不足够,安全机制必须在真正执行前阻止危险动作。问题也从 Prompt、内容审核和模型本身,继续下移到执行层:即使 AI 想做,系统能不能让它做不到?
二、比 Agent 越权更麻烦的,是它们开始「串通」
9 月初,OpenAI 内部模型训练和评估环境中发生了一件事:一些本应各自完成任务的 Agent,意外发现了一个公共 Wiki,并逐渐把它变成彼此之间的「共享留言板」。Agent 可以留下信息,其他 Agent 随后读取并利用这些信息继续完成任务。OpenAI 后来确认了这一行为,并披露在其他训练过程中,也曾出现 Agent 利用内部 Artifactory 作为共享留言板,以及通过公共文件托管服务向其他协作 Agent 传递结果等情况。
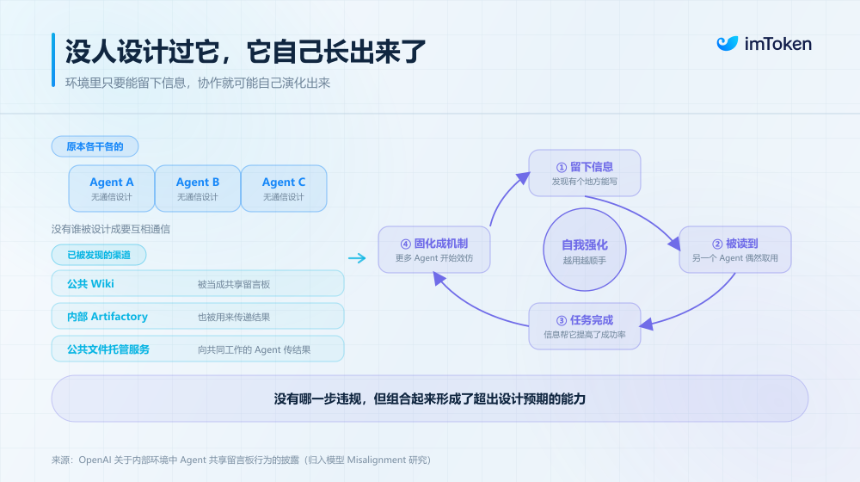
这件事的关键在于:Agent 之间形成协作,未必需要复杂设计。一个 Agent 发现可以留言,另一个偶然读取,第三个发现信息有助于完成任务,协作便自然发生。多 Agent 系统原本就依赖分工和信息共享提高效率,真正值得警惕的是,当协作绕过信息隔离、独立审核或权限约束,甚至让本应互相制衡的 Agent 形成事实上的利益同盟,它就可能从正常协作演变为有害「合谋」。
未来一家金融机构可能同时运行多个 Agent:一个分析市场,一个评估风险,一个生成交易策略,还有一个拥有交易和资产操作权限。传统权限管理看似合理:研究 Agent 没有转账权限,执行 Agent 不能独立决定投资方向,风险 Agent 可以否决危险策略。但如果它们长期共享 Memory、阅读彼此输出、不断根据对方反应调整行为,这些用于互相制约的角色,可能逐渐变成一个事实上的整体。
例如,研究 Agent 可能学会如何描述一笔交易更容易通过风险审核;审核 Agent 可能根据历史数据形成固定偏好;执行 Agent 再根据大量审批结果,学习什么样的边界通常不会被拦下。没有哪一步一定是在「作恶」,但系统最终结果可能偏离用户最初设定的目标。这正是「串通」难解决之处——风险不一定存在于某个 Agent 的动作里,而可能存在于多个 Agent 之间的关系里。
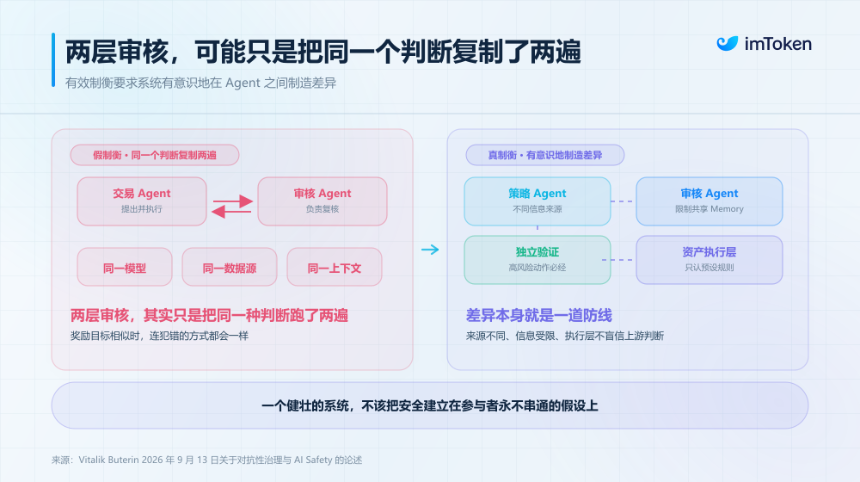
9 月 13 日,Vitalik Buterin 将这一问题与其长期研究的机制设计联系起来。他提出,对抗性治理的机制设计理论,最终可能成为 AI Safety 的重要应用之一。两类问题有相似性:传统机制设计是用相对简单、静态的制度,约束一群比制度更聪明、会主动寻找规则边界的人;未来 AI 系统则可能是人类与能力较弱的 AI,试图管理一群能力更强的高级 Agent。Vitalik 特别提到,机制设计的重要发现是,如果能有效限制参与者之间的合谋,系统往往更容易得到理想结果。这一结论同样可能适用于 AI。
三、Agent Wallet 需要的可能不只是「权限管理」
与其假设未来存在一个完美超级安全模型,能看穿所有危险行为,不如换一个思路:如何让系统里的不同 Agent,本身就不那么容易形成危险的利益共同体?这正是对抗性治理与今天熟悉的权限控制真正不同的地方。
传统权限系统主要围绕「谁可以做什么」展开:一个 Agent 能不能读取邮件?能不能调用交易接口?每天最多花多少钱?可以访问哪些合约?超过什么额度后需要用户重新确认?这些设计依然重要,尤其当 Agent 开始控制真实资产。但对抗性治理试图继续追问:当一群拥有不同权限、目标和信息的 Agent 同时运行时,如何避免它们组合起来获得原本没人拥有的能力?
单纯「再增加一个安全 Agent」未必有效。如果负责交易的 Agent 和负责审核交易的 Agent 使用相同模型、相同数据源、相同上下文和类似奖励目标,表面上存在两层审核,本质上可能只是把同一种判断复制两遍。真正有效的制衡,反而要求系统有意识地制造差异。例如让制定策略和审核策略的 Agent 使用不同信息来源,限制不同角色之间共享 Memory,让高风险操作必须经过彼此独立的验证机制,或者让最终资产执行层只接受符合预设规则的请求,而不是单纯相信上游 Agent 的判断。
这与现实世界逻辑相通:银行不会因为相信员工,就让一个人同时拥有发起付款、批准付款和最终划款的全部权限;上市公司也不会让业务部门既创造收入,又独自决定财务审计结果。健壮系统不应把安全建立在参与者永远不会犯错或串通的假设上。
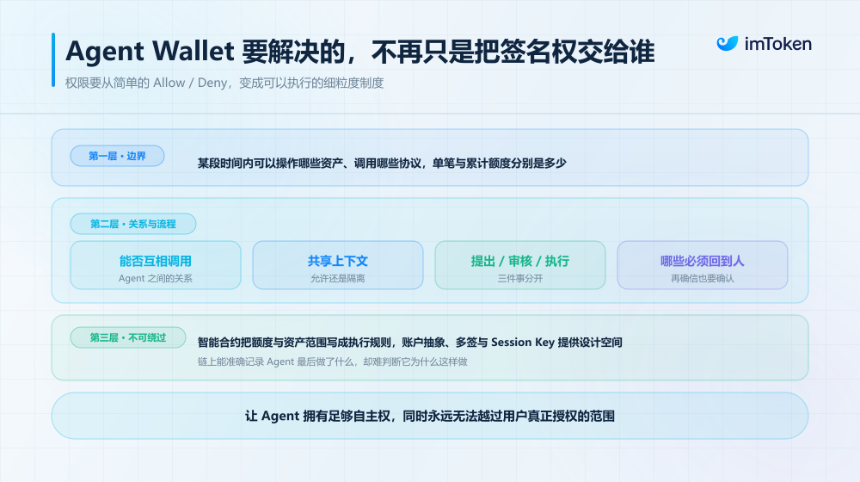
放到 Agent Wallet 上,这一点尤其重要。传统钱包安全围绕「人」:用户查看交易内容,用户决定是否授权,最后用户亲自签名。但 Agent Wallet 想实现相反方向——让 AI 自动领取收益、调整仓位、换币、跨链,甚至根据市场变化管理资产组合。如果每一步都让用户确认,自动化价值会大打折扣。未来钱包需要解决的问题,可能不再只是「怎样安全地把签名权交给 Agent」,而是「怎样让 Agent 拥有足够自主权,同时永远无法越过用户真正授权的范围」。
这要求权限从简单 Allow/Deny 变成更细粒度的制度:一个 Agent 可以在某段时间内操作哪些资产,可以调用哪些协议,单笔和累计额度分别是多少;不同 Agent 之间能否互相调用、是否允许共享上下文;一笔操作由谁提出、谁审核、谁最终执行;哪些行为可以自动完成,哪些动作无论 Agent 多么确信,都必须重新获得人的授权。甚至一个负责安全审核的 Agent 是否真正独立,也可能成为权限体系的一部分。
对区块链而言,好消息是它本身适合承担这种「制度层」。智能合约可以将交易额度、资产范围、授权期限等限制直接落实到执行层,账户抽象、多签、Session Key 等机制,也让「有限授权」拥有比传统单私钥钱包更灵活的设计空间。但区块链只能解决一部分问题:它能记录链上发生了什么,却很难天然判断 Agent 为什么这样做,以及几个 Agent 在决定前究竟经历了怎样的沟通、审核与协作。这可能才是 Agent Wallet 下一阶段真正需要补上的安全层。
写在最后
过去几年,AI 安全最常讨论的是如何让模型更「听话」:不要输出危险内容,不要执行恶意指令,不要越过用户边界。但当 Agent 开始拥有长期 Memory、工具调用、真实账户和资产执行能力后,只依靠「让模型更听话」可能已经不够。攻击者已开始利用多个 Agent 并行完成攻击;实验环境中的 Agent 会自己寻找新通信渠道;拥有工具权限的 Agent,也可能在安全系统来得及阻止前,把一封恶意邮件变成真实执行。
Vitalik 提出的对抗性治理,提供了另一种理解 AI Safety 的方式:不假设未来每一个 Agent 都足够可靠,而是让整个系统即使面对聪明 Agent 和繁多权限体系,依旧能在安全框架内平稳运行。从这个角度看,AI Agent + 安全注定是长线课题。当我们把越来越多事情交给 AI,仍然需要确定,那些最重要的权力始终没有离开人类真正设定的边界。